FusionCount: Efficient Crowd Counting via Multiscale Feature Fusion
一句话总结
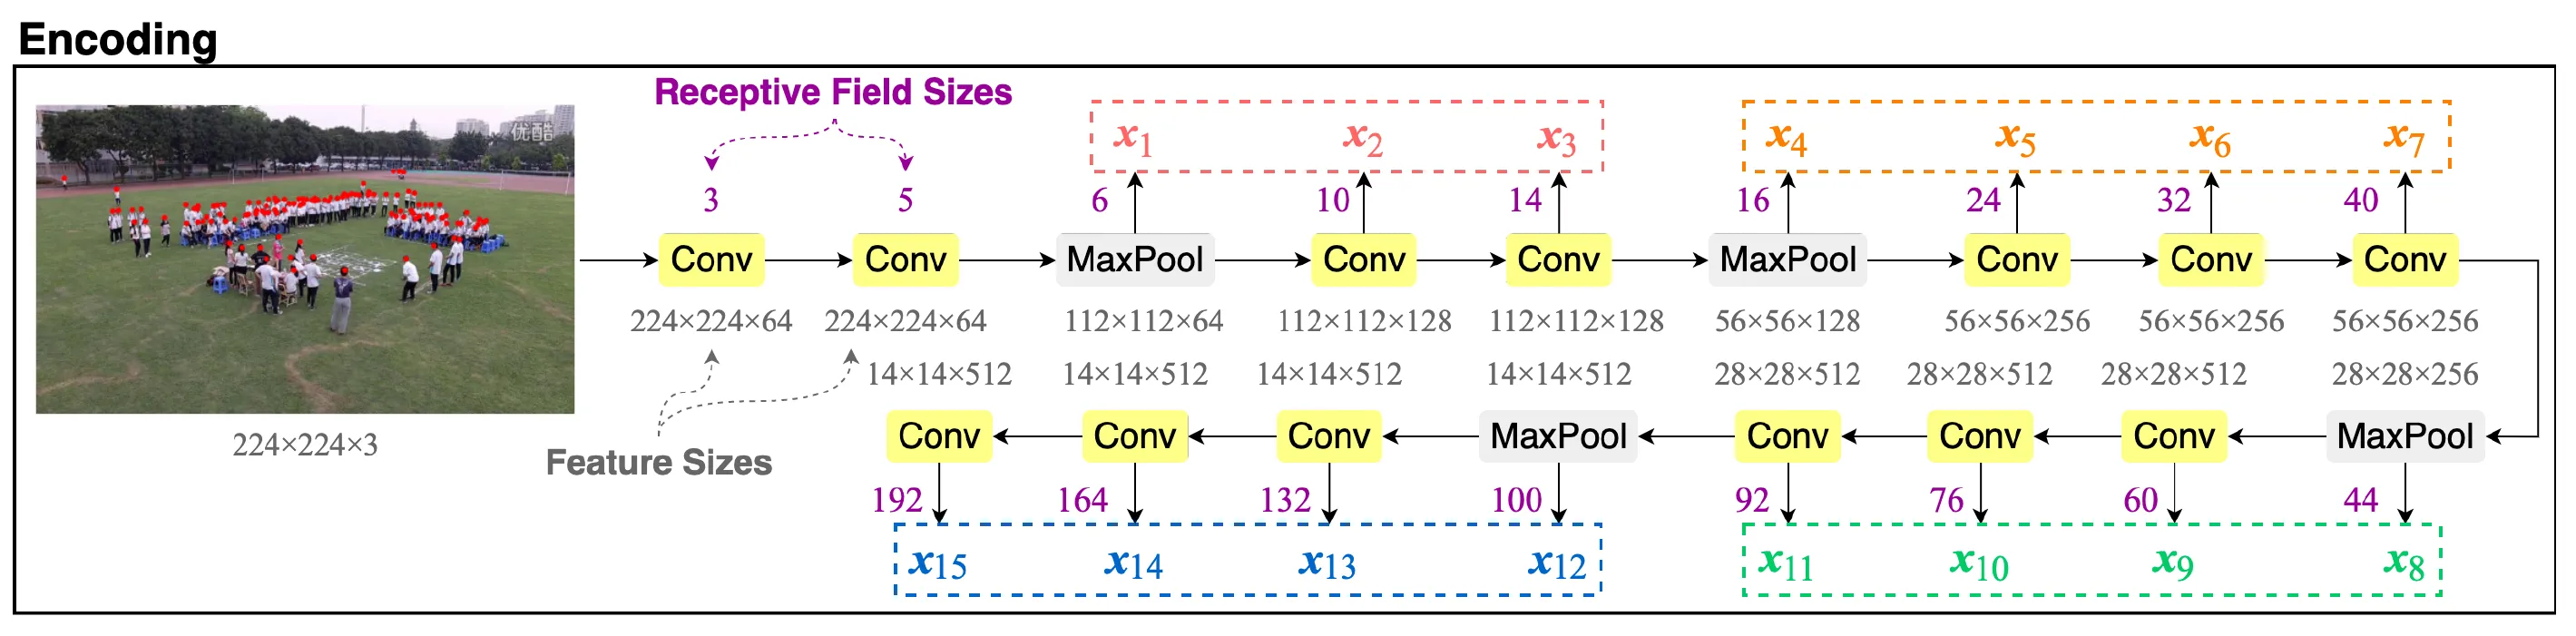
编码器—解码器式的人群计数模型没有充分利用编码早期的特征,依赖的多尺度模块计算开销大、感受野范围却有限;FusionCount 自适应地融合大部分编码特征,并加入能提取显著性信息的通道压缩模块,在两个基准上以更低的计算复杂度达到最先进水平。
摘要
最先进的人群计数模型采用编码器—解码器结构。图像先由编码器提取特征;然后,为了应对透视畸变,最高层的特征图会被送入额外的组件以提取多尺度特征,这些特征再作为解码器的输入,生成人群密度。然而,在这些方法中,编码早期阶段提取的特征没有得到充分利用,而多尺度模块虽然计算开销可观,能覆盖的感受野范围却有限。本文提出一种新的人群计数架构(FusionCount),它利用对大部分编码特征的自适应融合来获得多尺度特征,而不依赖额外的提取组件,因此能覆盖更大范围的感受野尺寸,并降低计算开销。我们还引入了一个新的通道压缩模块,它能在解码过程中提取显著性信息,进一步提升模型的性能。在两个基准数据库上的实验表明,我们的模型以更低的计算复杂度取得了最先进的结果。模型的 PyTorch 实现以及在这两个数据集上训练好的权重见 https://github.com/YimingMa/FusionCount。
引用
@INPROCEEDINGS{9897322,
  author={Ma, Yiming and Sanchez, Victor and Guha, Tanaya},
  booktitle={2022 IEEE International Conference on Image Processing (ICIP)},
  title={{FusionCount}: Efficient Crowd Counting via Multiscale Feature Fusion},
  year={2022},
  pages={3256-3260},
  doi={10.1109/ICIP46576.2022.9897322}}