来源 本文主要参考苏剑林的《Transformer 升级之路:1、Sinusoidal 位置编码追根溯源》,以及 Transformer 与 RoFormer 论文。
三十秒速览 一对 sin/cos 可以看成一根在单位圆上旋转的指针。token 每向前移动一步,指针就旋转固定角度;两个位置之间的距离,因此变成两根指针之间的相位差。只用一根指针会周期性重复,所以实际编码并排使用许多转速不同的指针。Sinusoidal 位置编码最漂亮的地方,不是“给每个位置分配不同数字”,而是把序列上的平移变成表示空间中的旋转。
先约定本文会反复使用的符号:
| 符号 | 含义 |
|---|
| m,n | 两个 token 的绝对位置编号 |
| Δ=m−n | 两个位置的相对位移 |
| d | 位置向量的总维度,通常为偶数 |
| i | 第 i 对 sin/cos 维度的编号 |
| θi | 第 i 根指针每前进一个 token 旋转的弧度 |
| λi=2π/θi | 第 i 根指针转一整圈所需的 token 数 |
| b | 几何频率调度的底数;经典 Transformer 取 b=10000 |
| pm | 位置 m 的完整位置向量 |
1. 没有位置编码,Self-attention 少了什么?
先考虑一个极简问题:“猫追狗”和“狗追猫”包含相同的三个 token,但顺序改变后,语义完全不同。模型若只知道每个 token 的内容,却没有任何位置相关信号,就缺少区分这两种顺序的坐标系。
更准确地说,先去掉 attention mask、位置 bias 和位置编码。令
X=[x1,x2,…,xN]⊤
表示一段 token representation,P 表示任意排列。纯 self-attention 满足
Attn(PX)=PAttn(X).
这叫排列等变性,不是排列不变性:输入按某种方式换序,输出也会跟着按同样方式换序。模型能够比较 token 的内容,却没有独立的“第几个”“在谁前面”“相距几步”等位置信号。
Decoder 的 causal mask 已经提供了“不能看未来”的方向约束,但它不是这里讨论的坐标编码。本文关心的是:怎样给每个位置一个向量,使模型不仅能区分绝对位置,还能方便地利用相对距离?
经典 Transformer 采用最直接的做法,在第 m 个 token 上加入位置向量:
x~m=xm+pm.
只要不同位置使用不同的 pm,原来的排列对称性就会被打破。但“每个位置不同”只是最低要求。
2. 只让每个位置“不同”为什么还不够?
比较两对位置:
(10,12)与(100,102).
它们的绝对坐标完全不同,但相对位移都是 −2。如果只需要让位置彼此不同,那么随机向量、one-hot 编码或一张可学习的 embedding 表都可以做到。更有结构的目标是:让模型容易发现这两对位置拥有相同的相对关系。
为了单独观察位置向量所提供的几何结构,先定义一个简化的位置交互核:
Kpos(m,n)=pm⊤pn.
我们希望它只依赖相对位移:
pm⊤pn=g(m−n).
于是,对任意整体平移 c,都有
pm+c⊤pn+c=g((m+c)−(n+c))=g(m−n).
这意味着:只要两对位置之间的距离相同,它们的纯位置相似度就相同。
这里必须先划清边界:pm⊤pn 是为了隔离位置结构而采用的简化分析对象,不是加法式位置编码的完整 attention score。真实 score 还会混合 token 内容和投影矩阵,第 7 节会把它完整展开。
此外,pm⊤pn=g(m−n) 只是一个清晰、可推导的充分条件,不是所有位置编码都必须遵守的定义。接下来要做的,是构造一族满足这个条件的简单向量。
3. 一只钟:Sin/Cos 如何表达相对位置?
先只使用两个维度。把位置 m 放到单位圆上:
pm=[cos(mθ)sin(mθ)].
这里的 θ 可以理解为“每前进一个 token,钟表指针旋转多少弧度”。因此:
- 位置 0 的角度是 0;
- 位置 1 的角度是 θ;
- 位置 m 的角度是 mθ;
- 当位置编号从 m 增加到 m+T,指针额外转过的角度是 Tθ;若 Tθ=2π,它就恰好走完一整圈,所以周期为 T=2π/θ。
这里变化的是位置编号 m,而 θ 是这根指针固定不变的“每步转角”。因此 mθ 表示走到第 m 个位置时已经累计转过的总角度。“走完一整圈”是指累计角度增加了 2π,指针回到单位圆上的同一点;若 2π/θ 不是整数,就不存在恰好经过整数个 token 后复位的时刻。
例如取 θ=π/4:
| 位置编号 m | 指针转过的总角度 mθ | 对应的二维向量 pm=[cos(mθ),sin(mθ)]⊤ |
|---|
| 0 | 0 | [1,0]⊤ |
| 1 | π/4 | [2/2,2/2]⊤ |
| 2 | π/2 | [0,1]⊤ |
| 3 | 3π/4 | [−2/2,2/2]⊤ |
位置 (0,2) 和 (1,3) 都相距两个 token。两对指针的夹角也都等于 2θ=π/2,所以内积都为 0。
一般地,两个位置向量的内积为
pm⊤pn=cos(mθ)cos(nθ)+sin(mθ)sin(nθ)=cos((m−n)θ).
第二步只是余弦差角公式。因此
pm⊤pn=cos((m−n)θ).
右侧不再分别依赖 m 和 n,只依赖相对位移 m−n。单位圆把
位置差 ⟷ 相位差
联系了起来。
经典公式通常把坐标顺序写成 [sin,cos],这里写成 [cos,sin]。这只是在同一对维度中交换坐标,不改变内积和旋转结构。
这段推导也不意味着 sin/cos 是唯一解。它只说明:如果我们寻找一个长度固定、随位置匀速旋转的二维表示,那么 sin/cos 是最自然、最简单的一族坐标。
4. 一只钟为什么不够?
钟表会周期性重复。如果 θ=2π/10,那么
cos((m+10)θ)sin((m+10)θ)=cos(mθ+2π)=cos(mθ),=sin(mθ+2π)=sin(mθ).
所以
pm+10=pm.
位置 m 和 m+10 会落在单位圆上的同一个点。这根二维指针在整数位置上只有 10 种不同相位;只要序列超过 10 个位置,它就会开始重复,因而无法独自区分相隔 10,20,30,… 个 token 的位置。这不表示整个 Transformer 只能容纳 10 个 token:限制来自这个特意选取的单一频率,实际编码会组合许多不同周期的指针。
高维 Sinusoidal 位置编码的做法,是把 d/2 根转速不同的钟并排放置:
pm=sin(mθ0)cos(mθ0)sin(mθ1)cos(mθ1)⋮sin(mθd/2−1)cos(mθd/2−1).
当其中一根钟回到原相位时,其他钟通常还没有同时复位。多频率因此能够:
- 减少单一周期造成的位置混淆;
- 同时提供对不同距离尺度的分辨能力。
较大的 θi 转得快,相邻 token 就会产生明显相位变化,对局部位移更敏感;较小的 θi 转得慢,可以在更长区间内保留缓慢变化的结构。
需要注意,多频率并不是对任意长度、任意有限精度下“绝不碰撞”的无条件保证。距离信息来自所有维度的联合相位,模型最终如何利用它仍然需要通过训练学习。
5. 为什么频率按几何级数排列?
把几何频率调度写成一般形式,就是
θi=b−2i/d.
其中 b>1 是控制整组频率跨度的底数。经典 Transformer 选择 b=10000,于是
θi=10000−2i/d,i=0,1,…,2d−1.
对应的周期为
λi=θi2π=2π100002i/d.
用 d=8 举例,可以直接看到这些钟的转速如何逐级变慢:
| 维度对 i | θi | 周期 λi(约) | 直觉 |
|---|
| 0 | 1 | 6.28 | 快速变化,偏局部 |
| 1 | 0.1 | 62.8 | 较短尺度 |
| 2 | 0.01 | 628 | 较长尺度 |
| 3 | 0.001 | 6283 | 缓慢变化,偏全局 |
这就是几何间隔的主要价值:用有限的维度比较均匀地覆盖对数尺度。如果改用等差频率,大量维度可能集中在某个狭窄的绝对范围;几何频率则像一把从局部放大到全局的多尺度尺子。
这里要把两个问题分开:
- 为什么是 sin/cos? 因为旋转和差角公式让相对位移自然出现在位置交互中。
- 为什么底数是 10000? 这是频率范围和分辨率的工程选择,不是由前面的恒等式唯一推出的常数。
Transformer 原论文给出的直接理由还包括:对于任意固定偏移 k,PEm+k 都能写成 PEm 的线性函数;固定函数也可以为训练时未见的更长位置生成编码。后一点只代表“公式可以计算”,不自动代表模型能够可靠完成长度外推。
6. 多频率位置核的距离特性:振荡式去相关
先把两个完整位置向量并排写出来:
pm=sin(mθ0)cos(mθ0)⋮sin(mθd/2−1)cos(mθd/2−1),pn=sin(nθ0)cos(nθ0)⋮sin(nθd/2−1)cos(nθd/2−1).
做内积时,同一频率的 sin 与 sin 相乘、cos 与 cos 相乘,再把所有频率对相加:
pm⊤pn=i=0∑d/2−1[sin(mθi)sin(nθi)+cos(mθi)cos(nθi)]=i=0∑d/2−1cos((m−n)θi).
最后一步对每一对维度使用了余弦差角公式。这个结果说明:完整向量的内积,就是所有钟对相位差的“投票总和”。
令 Δ=m−n,再除以钟的数量 d/2,得到归一化位置核
κd(Δ)=d2i=0∑d/2−1cos(Δθi).
这样归一化的好处是
κd(0)=1,
因为 Δ=0 时每一根钟都完全对齐,每个余弦项都等于 1。
当 ∣Δ∣ 很小时,不同频率的相位仍比较同步,许多余弦项会相互增强。距离增大后,各根钟的相位逐渐散开,正负项开始抵消,于是在常用距离范围内通常出现振荡式去相关:远处位置的平均相似度往往更小,但过程中会反复上下振荡。
为了把这个过程画清楚,图 1 的每一行都同时画出位置 m 和位置 n 的三根指针。因为位置核只依赖 Δ=m−n,可以不失一般性地把 m=0 作为参考位置;此时左侧钟面里的三根指针都指向 12 点。右侧钟面中,每根同色指针与参考方向的夹角由 ∣Δ∣θi 决定,这个夹角的余弦就是该频率对内积的贡献。
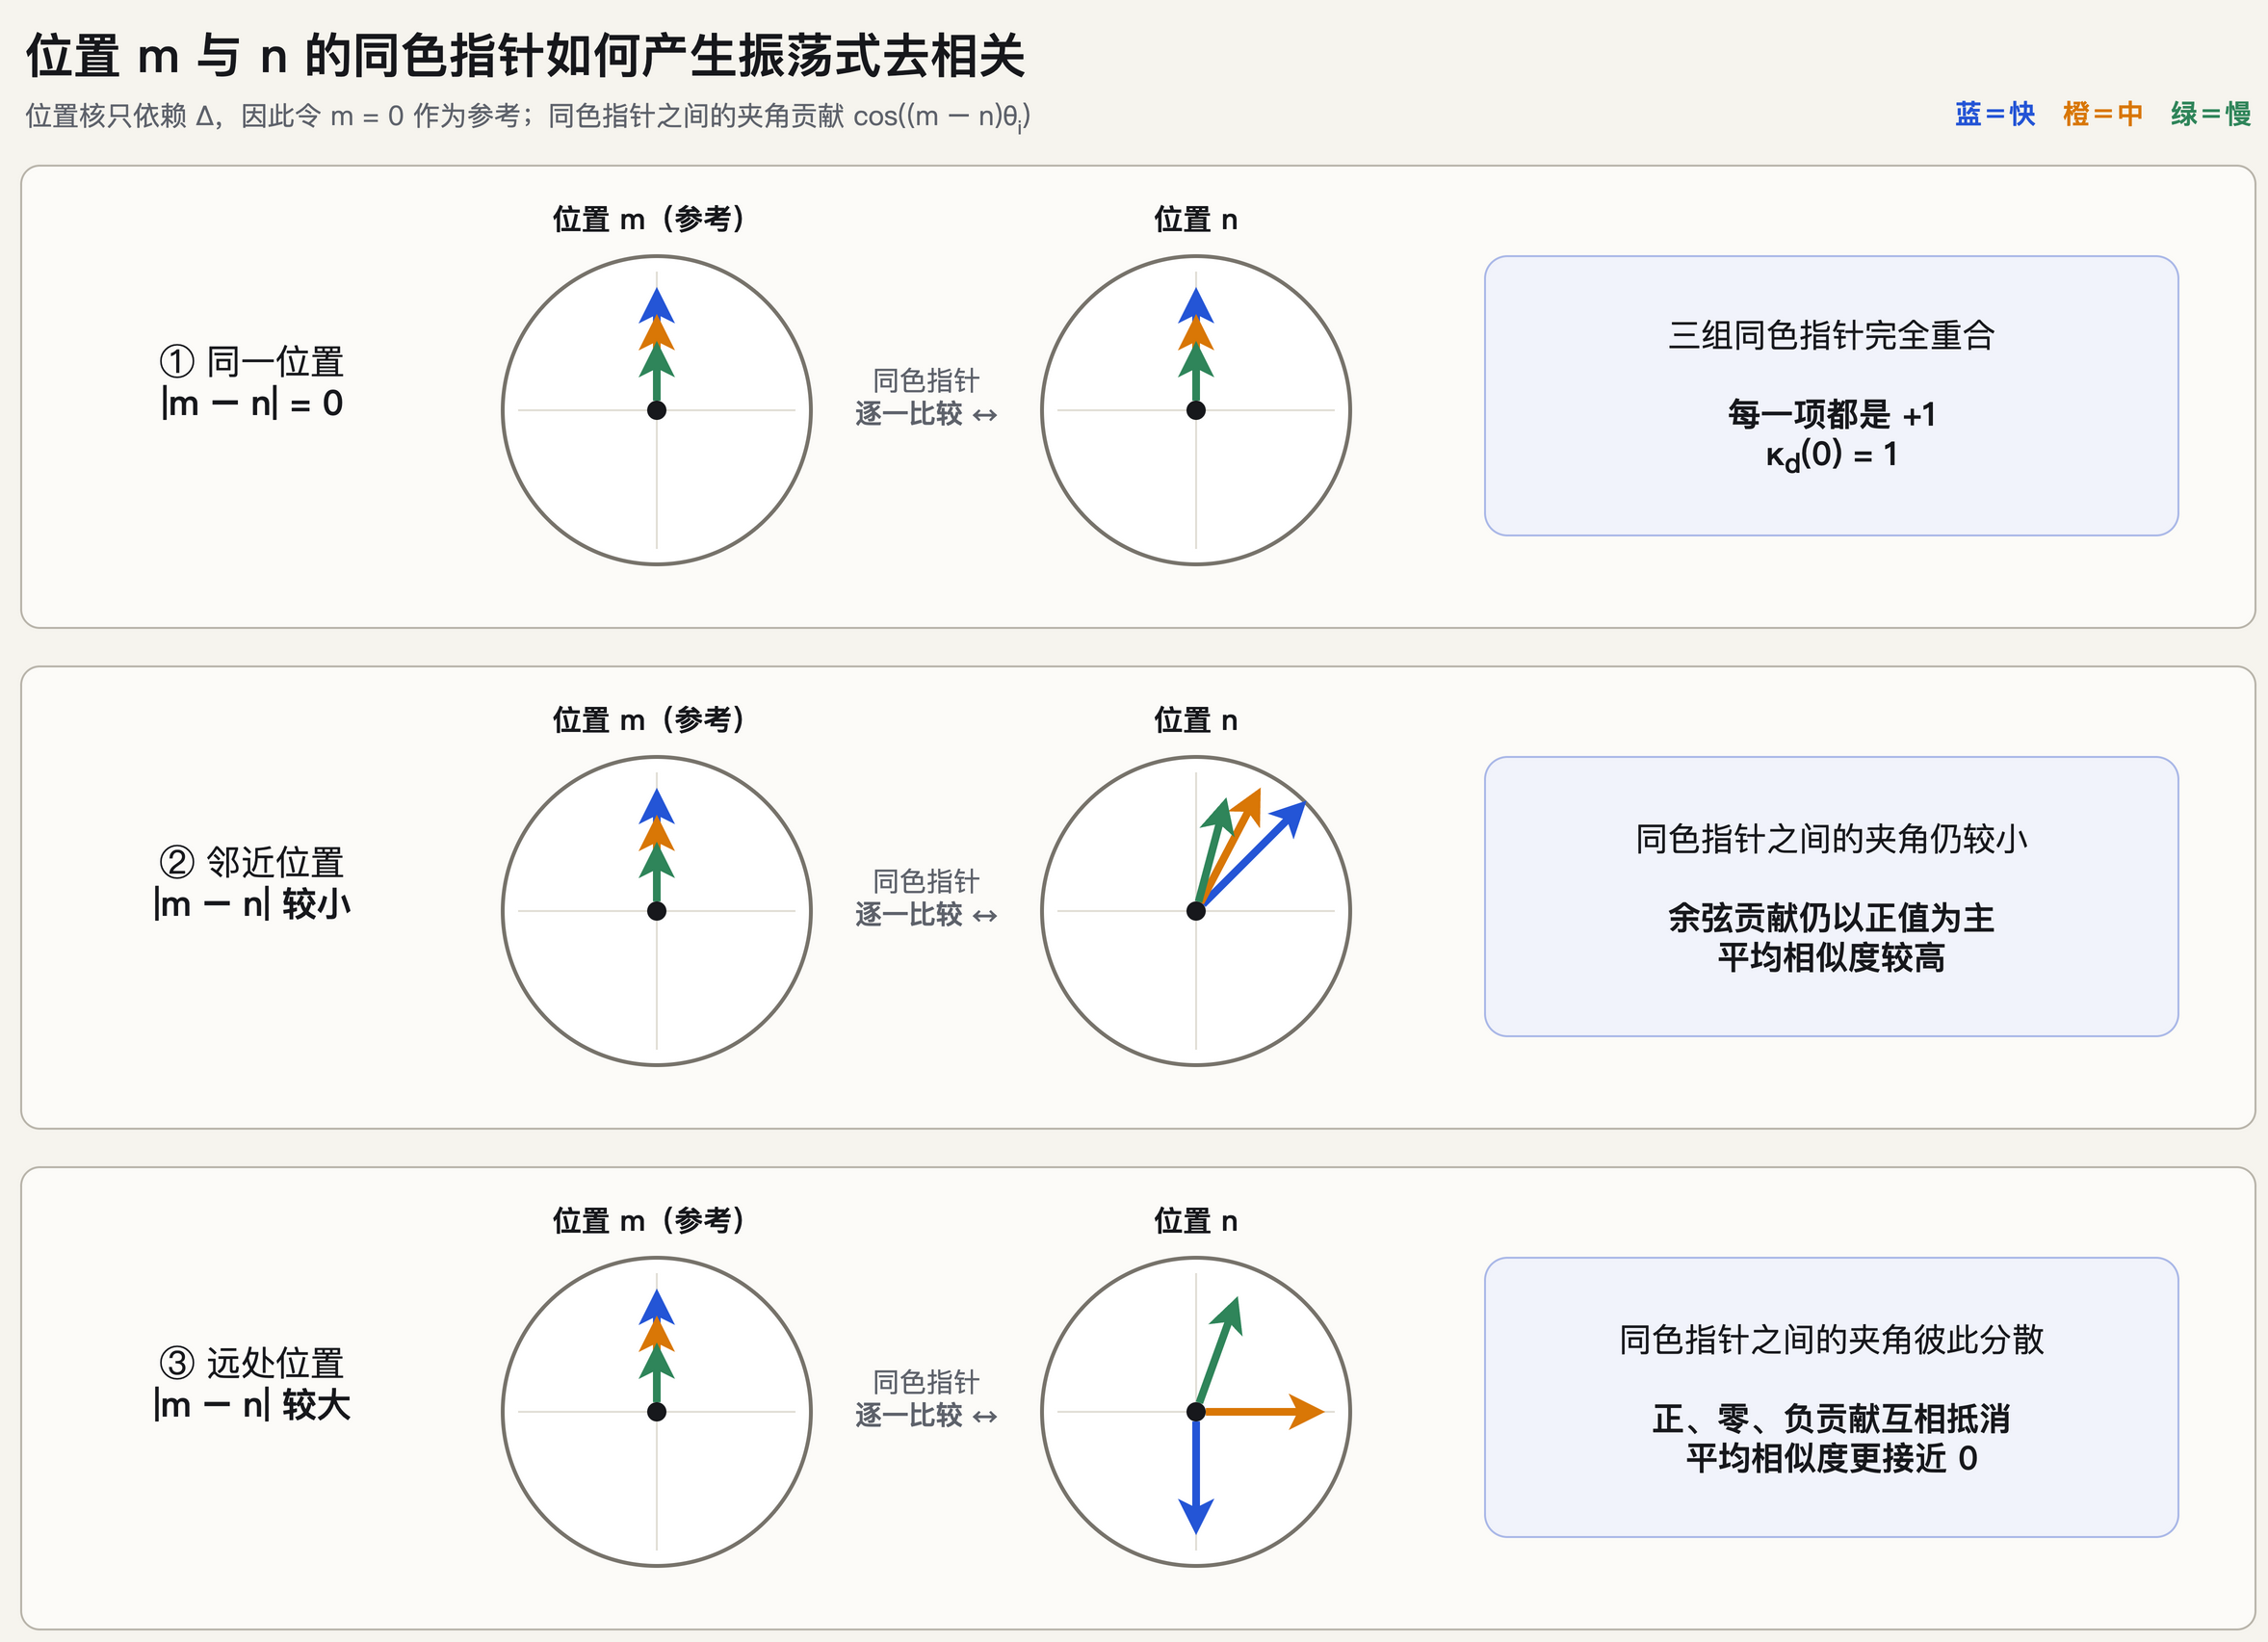 图 1|位置 m 与 n 的同色指针如何产生振荡式去相关。 每一行左侧钟面表示参考位置 m,右侧钟面表示待比较的位置 n;蓝、橙、绿分别代表快、中、慢三种频率。随着 |m − n| 增大,同色指针之间的夹角不再同步,正、零、负的余弦贡献更容易互相抵消。示意图不按比例。
要特别注意,被比较的每个二维块始终位于单位圆上,所以完整位置向量的长度恒为
∥pm∥=d/2.
距离变远时,位置编码本身不会“缩短到零”;可能变小的是两个位置向量的归一化内积 κd(Δ)。换句话说,变化的是方向之间的平均对齐程度,不是向量长度。
这里不能把“趋势”误读成严格定理:
对有限个频率,κd(Δ) 是有限余弦和。它不保证随距离单调下降,也不能一般性地宣称在 ∣Δ∣→∞ 时严格收敛到零。
为了观察大量离散频率的总体趋势,可以把频率编号 t=2i/d 看成 [0,1] 上的连续变量。由 θi=b−2i/d 得到 θ(t)=b−t,于是离散平均可近似写成
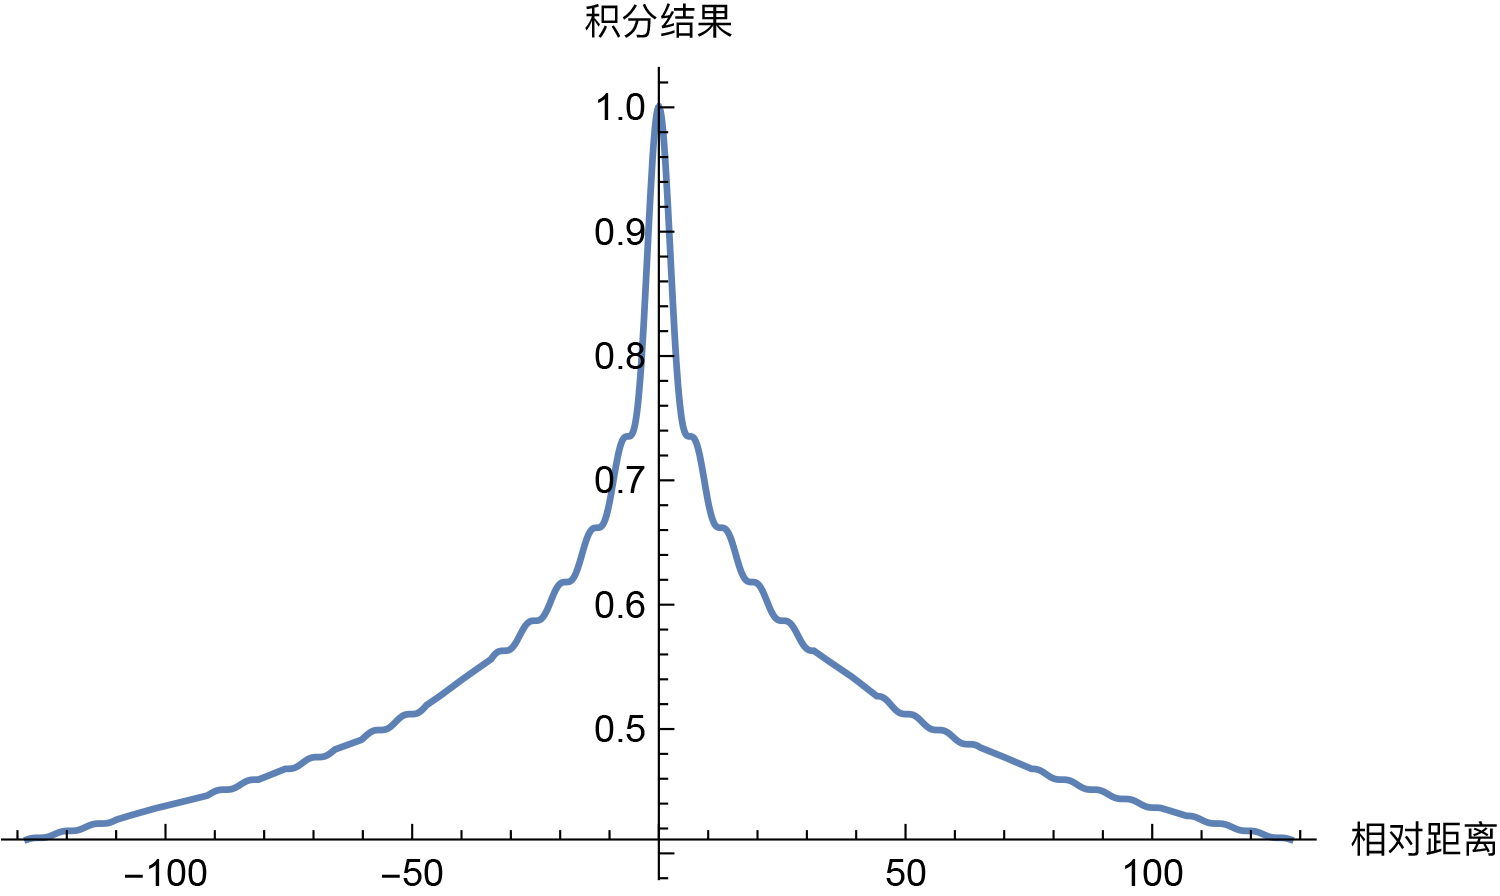
κd(Δ)≈∫01cos(Δb−t)dt.
这里的 b 就是第 5 节定义的频率调度底数,经典取值为 10000。这个积分可以理解为“把连续分布的许多不同转速的钟取平均”。随着 ∣Δ∣ 增大,被积函数关于 t 的正负振荡更加频繁,平均后更容易互相抵消。
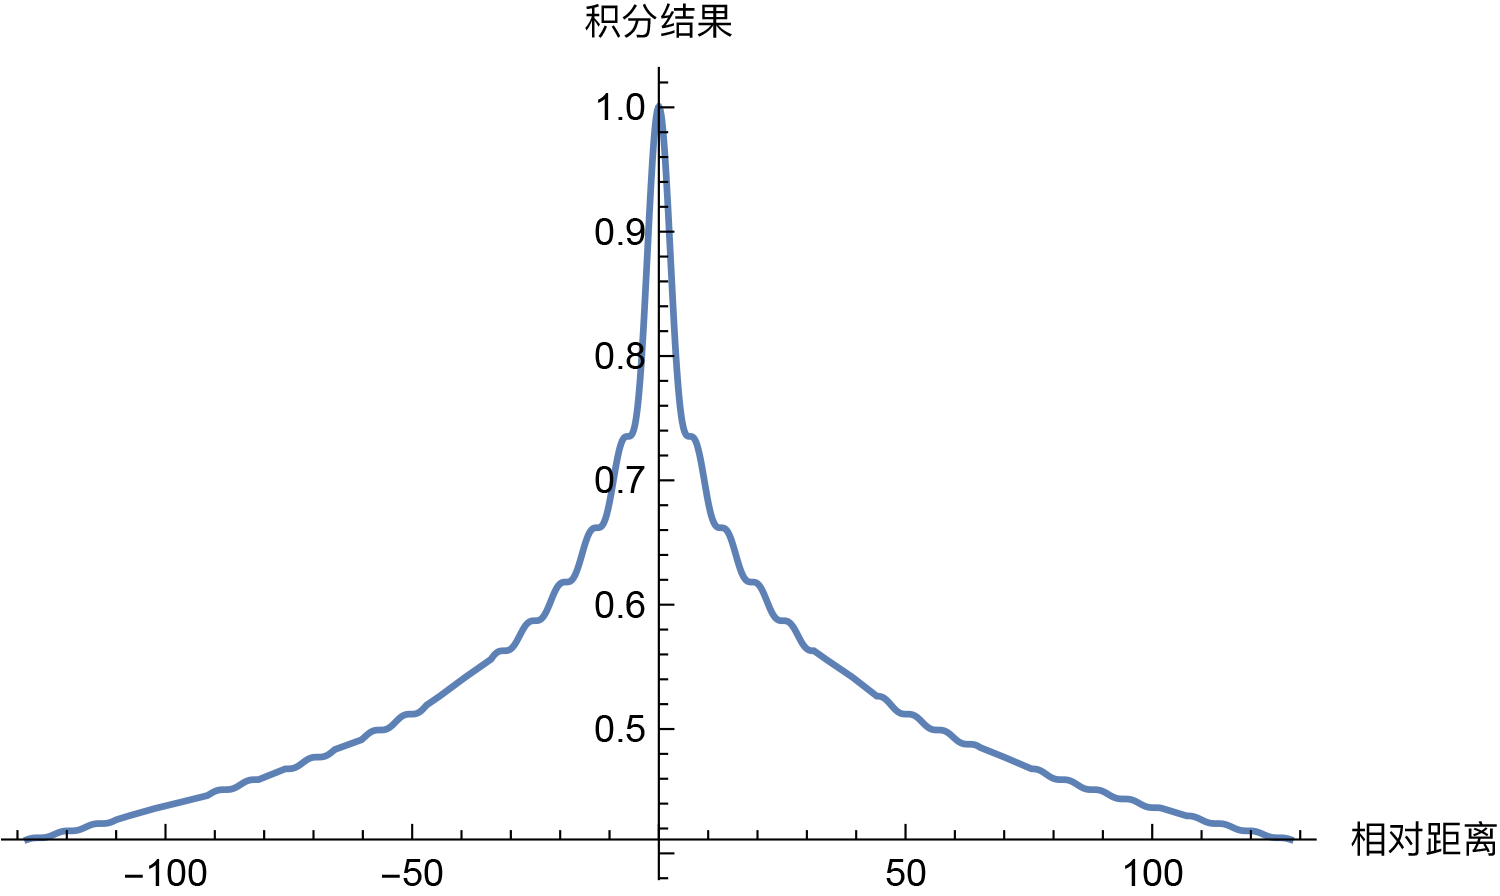 图 2|连续频率平均随相对距离变化的积分结果。 横轴是相对距离 |Δ|,纵轴是连续近似下的平均相似度;曲线从 Δ = 0 时的 1 出发,随后振荡,其整体幅度逐渐变小。它说明连续近似中的去相关趋势,不表示有限维内积严格单调下降。图像来自苏剑林《Transformer升级之路:1、Sinusoidal位置编码追根溯源》,科学空间,2021;按 CC BY-NC-ND 2.5 CN 原样转载。点击图片查看源文件。
这张图的作用,是把“许多不同频率的正负贡献逐渐抵消”变成可见的连续曲线;它不是用来证明某个有限维位置编码最终必然趋于零。调度 10000−t 也不是唯一选择,只是在局部分辨率、长距离变化和频率覆盖范围之间的一种工程折中。
本节结论:所谓“远程衰减”,更准确地说是振荡式去相关。 随着 ∣Δ∣ 增大,不同频率的相位更容易分散,归一化内积在常用距离范围内整体趋于更小;但有限频率的余弦和既不保证单调下降,也不保证极限为零。变化的是两个位置之间的平均相似度,不是位置向量本身的长度。
7. 真实 Attention 和这个简化模型有什么差别?
到这里,我们一直在研究 pm⊤pn。现在把它放回真实 attention。
忽略缩放常数和 bias,若 Query 与 Key 来自加入位置编码后的 token:
qm=WQ(xm+pm),kn=WK(xn+pn),
令
A=WQ⊤WK,
则 attention score 可以精确展开为
qm⊤kn=(xm+pm)⊤A(xn+pn)=内容–内容xm⊤Axn+内容–位置xm⊤Apn+位置–内容pm⊤Axn+位置–位置pm⊤Apn.
因此,真实 score 不会因为使用了 Sinusoidal 位置编码,就自动变成只依赖 m−n 的函数。前面的核心恒等式
pm⊤pn=g(m−n)
相当于先隔离纯位置交互,再用 A=I 的最简单情形观察编码本身提供了什么结构。
直接展开实际 attention score 后,边界也很清楚:当中间矩阵 A 是一般矩阵时,纯位置项 pm⊤Apn 未必只依赖 m−n;另外三项还会把内容与位置混合起来。因此,第 6 节的内积核是分析编码几何性质的简化工具,不是对完整 attention 行为的等价描述。
所以更准确的结论是:
Sinusoidal 位置编码为模型提供了可以利用的相对相位结构,但它不规定训练后的模型必须怎样使用这套结构。
8. 这套解释证明了什么,又没有证明什么?
它严格给出或直接展示了:
- 成对的 sin/cos 是二维旋转坐标;
- 同一频率对的内积严格等于 cos((m−n)θ);
- 固定位置偏移对应一个与绝对位置无关的旋转;
- 多频率把这种结构扩展到多种距离尺度;
- 几何频率在连续近似中产生振荡去相关趋势。
它没有证明:
- Sinusoidal PE 是唯一的位置编码;
- Sinusoidal PE 是最优的位置编码;
- 底数 10000 是理论必然或最佳选择;
- 有限维内积会随距离严格单调下降;
- 加法式 Sinusoidal PE 的真实 attention score 只依赖相对位置;
- 能为更长位置计算编码,就代表模型能够可靠完成长度外推。
这套分析真正有价值的地方,不是证明“Google 当年的公式无可替代”,而是展示一种可复用的思考方式:先提出希望位置表示具备的结构,再寻找一个简单的显式构造,最后检查这个构造还附带了哪些性质与假设。
9. 延伸:为什么这套思想自然通向 RoPE?
前面的“相对位移变成相位差”还可以通过另一种机制直接进入 attention,这正是理解 RoPE 的自然起点。
传统 Sinusoidal PE 把位置向量加到 token representation:
xm⟼xm+pm.
RoPE 则把位置对应的旋转直接施加到内容产生的 Query 和 Key 上。对一个二维频率块,记位置 m 的旋转为 Rm:
q~m=Rmqm,k~n=Rnkn.
它们的内积为
q~m⊤k~n=qm⊤Rm⊤Rnkn=qm⊤Rn−mkn.
完整 RoPE 会对不同维度对使用不同频率的二维旋转块。位置通过 Rn−m 显式进入 Q/K 内积,而完整分数仍然依赖内容 qm 和 kn。
因此两者共享“相对位移对应相位差”的数学核心,但机制并不相同:
- Sinusoidal PE:在输入端加入绝对位置向量,随后与内容一起经过投影;
- RoPE:在 Q/K 空间中直接旋转内容,使相对旋转显式出现在 score 中。
10. 一页速查
| 问题 | 最短答案 |
|---|
| 为什么需要位置编码? | 无位置 self-attention 具有排列等变性,缺少独立的顺序坐标。 |
| 为什么“每个位置不同”还不够? | 我们还希望模型容易发现 (10,12) 与 (100,102) 拥有相同的相对关系。 |
| 为什么使用 sin/cos? | 单位圆旋转使内积通过差角公式只依赖位置差。 |
| 为什么每两个维度配成一对? | 二维正好可以表示一根旋转指针的两个坐标。 |
| 为什么需要很多频率? | 单频率会周期重复;多频率减少混淆并提供多种尺度。 |
| 为什么使用几何频率? | 用有限维度较均匀地覆盖对数尺度。 |
| “振荡式去相关”是严格单调吗? | 不是。有限维内积是振荡的余弦和,只表现出常用范围内的去相关趋势。 |
| 10000 是理论必然吗? | 不是,它是频率范围与分辨率的工程选择。 |
| 真实 attention 只依赖相对距离吗? | 不是。加法式 PE 的 score 同时包含内容与位置的四类交互。 |
| 它和 RoPE 的关系是什么? | 两者都利用相位差;RoPE 把旋转直接放进 Q/K 内积。 |
整篇文章最值得记住的一句话是:
Sinusoidal 位置编码不是用三角函数“给位置编号”,而是用许多不同转速的钟,把相对位移表示成多尺度的相位差。
参考文献与图像来源
- Vaswani, A. et al. (2017). Attention Is All You Need,§3.5。
- 苏剑林(2021)。《Transformer 升级之路:1、Sinusoidal 位置编码追根溯源》。本文的问题意识、相对位置内积与连续频率近似均以该文为阅读起点;本文重新组织了教学顺序,并使用对 attention score 的直接拆解替代 Taylor 展开。
- Su, J. et al. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding。
- 图 1 为作者制作的机制示意图;图 2 取自苏剑林上述文章,遵循该站标注的 CC BY-NC-ND 2.5 CN 许可原样转载,点击图片可查看源文件。